主题
Kubernetes 1.36 部署 kube-prometheus-stack
一、方案说明
1.1 Kubernetes 监控实现思路
| 监控指标 | 具体实现 | 举例 |
|---|---|---|
| Pod 性能 | cAdvisor | Pod、容器的 CPU、内存工作集、RSS、Cache、Swap、文件系统使用量、磁盘 I/O、网络收发、错误和丢包 |
| Node 性能 | node-exporter | CPU 使用率和负载、内存与 Swap、磁盘容量与 inode、磁盘 I/O、网卡流量与错误、系统启动时间和时间偏差 |
| K8s 资源对象 | kube-state-metrics | Pod、Deployment、service、pvc 等等 |
1.2 收集的监控项
| 分类 | 指标来源 | 主要监控项 |
|---|---|---|
| Kubernetes 集群与对象状态 | kube-state-metrics | Node Ready 状态、资源容量与可分配量;Namespace、Pod、Service、Endpoint、ConfigMap、Secret 等对象状态和数量 |
| 工作负载状态 | kube-state-metrics | Deployment、StatefulSet、DaemonSet 的期望/可用副本;Job、CronJob 执行状态;HPA、PDB 状态;Pod 调度、Pending、重启和容器等待原因 |
| Pod 与容器资源 | kubelet/cAdvisor | Pod、容器的 CPU、内存工作集、RSS、Cache、Swap、文件系统使用量、磁盘 I/O、网络收发、错误和丢包 |
| Kubernetes 节点 | node-exporter | CPU 使用率和负载、内存与 Swap、磁盘容量与 inode、磁盘 I/O、网卡流量与错误、系统启动时间和时间偏差 |
| kubelet 与容器运行时 | kubelet | kubelet 存活状态、Pod 启动耗时、PLEG、容器运行时操作、驱逐、证书有效期、Volume 统计和指标采集状态 |
| API Server | kube-apiserver | API 请求量、状态码、错误率、请求延迟、当前并发请求、对象数量以及 API 可用性和 SLO |
| 集群网络与 DNS | node-exporter、cAdvisor、CoreDNS | 节点和容器网络流量、错误、丢包;CoreDNS 查询量、响应码、解析延迟、缓存和上游转发状态 |
| Kubernetes 存储 | kube-state-metrics、kubelet | PV/PVC 阶段、绑定状态、StorageClass、申请容量;挂载卷容量、已用/可用空间和 inode 使用量 |
| 监控系统自身 | Prometheus、Operator 等组件的 /metrics | Target 状态、抓取耗时和样本量、TSDB/WAL、规则执行、配置加载和 Operator 调谐状态 |
1.3 组件说明
kube-prometheus-stack 是 Prometheus Community 维护的 Kubernetes 监控 Helm Chart,集成:
| 组件 | 用途 |
|---|---|
| Prometheus Operator | 通过 CRD 管理 Prometheus 和采集配置 |
| Prometheus | 采集、存储和查询指标 |
| kube-state-metrics | 采集 Node、Pod、Deployment、PV、PVC 等对象状态 |
| node-exporter | 采集节点 CPU、内存、磁盘和网络指标;通过 Web Basic Auth 保护采集端点 |
| kubelet/cAdvisor | 采集 Pod 和容器资源指标 |
| Grafana | 展示预置 Kubernetes 看板 |
| PrometheusRule | 提供记录规则和告警规则 |
| ServiceMonitor/PodMonitor | 声明监控目标 |
与单独安装 Prometheus 相比,它同时提供 Operator、自动发现、Kubernetes 规则、node-exporter、kube-state-metrics 和 Grafana 看板,不需要手工维护完整的 prometheus.yml。
项目地址:
- https://github.com/prometheus-community/helm-charts/tree/main/charts/kube-prometheus-stack
- https://artifacthub.io/packages/helm/prometheus-community/kube-prometheus-stack
二、本次部署参数
| 项目 | 配置 |
|---|---|
| Kubernetes | v1.36.4 |
| Helm | v4.2.4 |
| Chart | kube-prometheus-stack 90.0.0 |
| Namespace | monitoring |
| Helm Release | kps |
| NFS Server | 172.22.33.99:/home/application/nfs/data |
| StorageClass | nfs-dynamic |
| Prometheus PVC | 50Gi,保留 15 天,最大 40GiB |
| VictoriaMetrics Remote Write | https://vms.srebro.cn/api/v1/write |
| 集群标识 | k8s_type="demo" |
| Grafana PVC | 10Gi |
| Prometheus NodePort | 30090 |
| Grafana NodePort | 30300 |
| Grafana 时区 | Asia/Shanghai(UTC+8) |
| node-exporter | hostNetwork: true,通过每个节点的 9100 对外提供,用户名/密码为 admin/admin |
节点:
| 主机 | IP |
|---|---|
| k8s-master01 | 172.22.33.100 |
| k8s-node01 | 172.22.33.101 |
| k8s-node02 | 172.22.33.102 |
WARNING
Prometheus 官方不支持使用 NFS 存放本地 TSDB。本方案接受其性能及可靠性风险,并保持 Prometheus、Grafana 单副本。
NOTE
Prometheus 当前没有登录认证,后续通过 Traefik Middleware 暴露 prometheus 地址,增加认证。
WARNING
node-exporter 通过宿主机网络开放 9100,但启用了 Basic Auth。HTTP Basic Auth 不加密传输内容。
三、安装 Helm 二进制
Helm 只需要安装在执行部署命令的管理节点 k8s-master01,不需要安装到所有 Kubernetes 节点。本方案使用 Linux AMD64 版本的 Helm v4.2.4。
3.1 下载安装
bash
cd /etc/kubernetes/addons

wget https://get.helm.sh/helm-v4.2.4-linux-amd64.tar.gz

tar -xf helm-v4.2.4-linux-amd64.tar.gz
install -m 0755 linux-amd64/helm /usr/local/bin/helm

helm version3.2 验证 Helm 能访问集群
bash
kubectl config current-context
kubectl get nodes
helm list -AHelm 使用当前用户的 kubeconfig 访问 Kubernetes。若 kubectl get nodes 无法正常执行,先处理 kubeconfig,再继续部署。
四、部署前检查
在 k8s-master01 执行:
bash
kubectl get service -A \
  -o custom-columns=NAMESPACE:.metadata.namespace,NAME:.metadata.name,NODEPORT:.spec.ports[*].nodePort \
| grep -E '30090|30300' || true在三个 Kubernetes 节点分别确认 9100 没有被其他程序占用:
bash
ss -lntp | grep ':9100' || true创建工作目录:
bash
mkdir -p /etc/kubernetes/addons/kube-prometheus-stack五、选择 Chart 来源
5.1 在线获取
bash
cd /etc/kubernetes/addons/kube-prometheus-stack

helm repo add prometheus-community \
  https://prometheus-community.github.io/helm-charts

helm repo update

helm search repo prometheus-community/kube-prometheus-stack \
--versions | head5.2 根据 Kubernetes 版本选择 kube-prometheus-stack 版本
查看集群版本,以输出中的 Server Version 为准:
bash
kubectl version查看候选 Chart 的 Kubernetes 版本要求:
bash
helm show chart prometheus-community/kube-prometheus-stack \
--version 90.0.0如果已下载 Chart,也可以离线查看:
bash
helm show chart ./kube-prometheus-stack-90.0.0.tgz重点查看以下字段:
yaml
version: 90.0.0
appVersion: v0.93.1
kubeVersion: ">=1.25.0-0"version:Chart 版本。appVersion:Prometheus Operator 版本,不是 Prometheus 版本。kubeVersion:Chart 声明的 Kubernetes 版本范围,本例要求 Kubernetes 1.25 及以上。
本集群 1.36.4 满足 Chart 90.0.0 的版本约束。两者不是一一对应关系;选择其他 Chart 版本时,检查该版本的 kubeVersion 和升级说明,并在部署前验证。满足版本约束不等于所有组件都经过该组合的完整兼容性验证。
官方版本要求:Chart 90.0.0 的 Chart.yaml。
5.3 离线获取
适用于集群不能访问官方仓库的环境。在一台能访问外网的电脑下载:
bash
curl -fL \
  -o kube-prometheus-stack-90.0.0.tgz \
https://github.com/prometheus-community/helm-charts/releases/download/kube-prometheus-stack-90.0.0/kube-prometheus-stack-90.0.0.tgz六、创建 Namespace 和认证 Secret
6.1 创建 Namespace 和 Grafana 密码
bash
kubectl create namespace monitoring \
  --dry-run=client -o yaml | kubectl apply -f -


kubectl -n monitoring create secret generic grafana-admin \
  --from-literal=admin-user=admin \
  --from-literal=admin-password="admin" \
--dry-run=client -o yaml | kubectl apply -f -6.2 node-exporter 启用 Basic Auth(基础身份验证)
创建密码文件:使用 htpasswd 生成(若无该工具,先安装 httpd-tools):
bash
dnf install -y httpd-toolsWARNING
bcrypt 哈希值不可逆,不能通过反向解密验证密码,请妥善保存凭据。
bash
# 创建凭证目录
mkdir -p /etc/kubernetes/addons/kube-prometheus-stack/secrets

# 生成 htpasswd 文件。提示输入密码时输入 admin
htpasswd -nBC 10 admin > /etc/kubernetes/addons/kube-prometheus-stack/secrets/.htpasswd
# 输入密码后,文件将存储加密后的凭据。
# New password:
# Re-type new password:将 htpasswd 中的 bcrypt 密码转换成 node-exporter 所需的 Web 配置文件 node-exporter-web-config.yml:
bash
NODE_EXPORTER_BCRYPT="$(
  cut -d: -f2- \
  /etc/kubernetes/addons/kube-prometheus-stack/secrets/.htpasswd
)"

printf 'basic_auth_users:\n  admin: %s\n' \
  "${NODE_EXPORTER_BCRYPT}" \
  > /etc/kubernetes/addons/kube-prometheus-stack/secrets/node-exporter-web-config.yml

unset NODE_EXPORTER_BCRYPT

chmod 600 \
  /etc/kubernetes/addons/kube-prometheus-stack/secrets/.htpasswd \
/etc/kubernetes/addons/kube-prometheus-stack/secrets/node-exporter-web-config.yml创建 Secret。username 和 password 供 ServiceMonitor 使用,web-config.yml 供 node-exporter 服务端使用:
bash
kubectl -n monitoring create secret generic node-exporter-web-auth \
  --from-literal=username=admin \
  --from-literal=password=admin \
  --from-file=web-config.yml=/etc/kubernetes/addons/kube-prometheus-stack/secrets/node-exporter-web-config.yml \
--dry-run=client -o yaml | kubectl apply -f -检查 Secret 是否包含三个键,不要直接输出 Secret 内容:
bash
kubectl -n monitoring get secret node-exporter-web-auth \
-o go-template='{{range $k,$v := .data}}{{$k}}{{"\n"}}{{end}}'七、获取默认 values
在线方式:
bash
cd /etc/kubernetes/addons/kube-prometheus-stack
helm show values \
  prometheus-community/kube-prometheus-stack \
  --version 90.0.0 \
> kube-prometheus-stack-default-values.yaml离线方式:
bash
cd /etc/kubernetes/addons/kube-prometheus-stack
helm show values \
  ./kube-prometheus-stack-90.0.0.tgz \
> kube-prometheus-stack-default-values.yaml八、根据默认 values 创建 kps-values.yaml
- 本配置启用 node-exporter,通过
hostNetwork在每个节点监听9100。 - node-exporter 指标接口启用 Basic Auth,ServiceMonitor 使用 Secret 中的凭据进行采集。
- Prometheus 保留本地存储,并将所有监控数据发送到远端的 VictoriaMetrics 存储;远端数据统一增加
k8s_type="demo"标签,用于区分不同来源的数据。
bash
cd /etc/kubernetes/addons/kube-prometheus-stack
vim kps-values.yamlyaml
kubeTargetVersionOverride: "1.36.4"

defaultRules:
  create: true
  rules:
    alertmanager: false

windowsMonitoring:
  enabled: false

kubeApiServer:
  enabled: true

kubelet:
  enabled: true
  serviceMonitor:
    cAdvisor: true
    probes: true
    resource: false

kubeControllerManager:
  enabled: false

kubeScheduler:
  enabled: false

kubeEtcd:
  enabled: false

kubeProxy:
  enabled: false

coreDns:
  enabled: true

kubeStateMetrics:
  enabled: true

nodeExporter:
  enabled: true

prometheus-node-exporter:
  hostNetwork: true
  service:
    type: ClusterIP
    listenOnAllInterfaces: true
  prometheus:
    monitor:
      enabled: true
      scheme: http
      basicAuth:
        username:
          name: node-exporter-web-auth
          key: username
        password:
          name: node-exporter-web-auth
          key: password
  extraArgs:
    - --collector.filesystem.mount-points-exclude=^/(dev|proc|sys|run/containerd/.+|var/lib/docker/.+|var/lib/kubelet/.+)($|/)
    - --collector.filesystem.fs-types-exclude=^(autofs|binfmt_misc|bpf|cgroup2?|configfs|debugfs|devpts|devtmpfs|fusectl|hugetlbfs|iso9660|mqueue|nsfs|overlay|proc|procfs|pstore|rpc_pipefs|securityfs|selinuxfs|squashfs|sysfs|tracefs|erofs)$
    - --web.config.file=/etc/node-exporter/web-config.yml
  secrets:
    - name: node-exporter-web-auth
      mountPath: /etc/node-exporter
  livenessProbe:
    httpGet:
      scheme: http
      httpHeaders:
        - name: Authorization
          value: Basic YWRtaW46YWRtaW4=
  readinessProbe:
    httpGet:
      scheme: http
      httpHeaders:
        - name: Authorization
          value: Basic YWRtaW46YWRtaW4=
  resources:
    requests:
      cpu: 50m
      memory: 64Mi
    limits:
      cpu: 300m
      memory: 256Mi

kube-state-metrics:
  resources:
    requests:
      cpu: 50m
      memory: 128Mi
    limits:
      cpu: 500m
      memory: 512Mi

prometheusOperator:
  enabled: true
  resources:
    requests:
      cpu: 100m
      memory: 128Mi
    limits:
      cpu: 500m
      memory: 512Mi

prometheus:
  enabled: true
  service:
    type: NodePort
    nodePort: 30090
  prometheusSpec:
    replicas: 1
    shards: 1
    scrapeInterval: 30s
    scrapeTimeout: 10s
    evaluationInterval: 30s
    externalLabels:
      k8s_type: demo
    remoteWrite:
      - name: central-victoriametrics
        url: https://vms.srebro.cn/api/v1/write
        remoteTimeout: 30s
    retention: 15d
    retentionSize: 40GiB
    walCompression: true
    enableAdminAPI: false
    persistentVolumeClaimRetentionPolicy:
      whenDeleted: Retain
      whenScaled: Retain
    resources:
      requests:
        cpu: 500m
        memory: 2Gi
      limits:
        cpu: "2"
        memory: 4Gi
    storageSpec:
      volumeClaimTemplate:
        spec:
          storageClassName: nfs-dynamic
          accessModes:
            - ReadWriteOnce
          resources:
            requests:
              storage: 50Gi

alertmanager:
  enabled: false

grafana:
  enabled: true
  # kube-prometheus-stack 内置 Dashboard 的时区
  defaultDashboardsTimezone: Asia/Shanghai
  # Grafana 服务端默认时区
  grafana.ini:
    date_formats:
      default_timezone: Asia/Shanghai
  admin:
    existingSecret: grafana-admin
    userKey: admin-user
    passwordKey: admin-password
  service:
    type: NodePort
    nodePort: 30300
  persistence:
    enabled: true
    type: sts
    storageClassName: nfs-dynamic
    accessModes:
      - ReadWriteOnce
    size: 10Gi
  ingress:
    enabled: false
  resources:
    requests:
      cpu: "1"
      memory: 2Gi
    limits:
      cpu: "2"
memory: 4Gi保存为:
text
/etc/kubernetes/addons/kube-prometheus-stack/kps-values.yaml九、在线 Helm 部署
9.1 在线渲染并提取镜像
bash
cd /etc/kubernetes/addons/kube-prometheus-stack


#把 Helm Chart 转换成最终的 Kubernetes YAML 文件
helm template kps \
  prometheus-community/kube-prometheus-stack \
  --version 90.0.0 \
  --namespace monitoring \
  -f kps-values.yaml \
  > kps-online-rendered.yaml

#提取镜像
awk '$1 == "image:" {print $2}' kps-online-rendered.yaml \
  | tr -d "\"'" \
  | sort -u \
  > kps-online-images.txt

#查看镜像地址
cat kps-online-images.txt

#查看重要配置
grep -n 'storageClassName: nfs-dynamic' kps-online-rendered.yaml
grep -nE 'type: NodePort|nodePort: (30090|30300)' kps-online-rendered.yaml9.2 在线预拉取镜像
所有节点都需要执行
bash
docker pull docker.cnb.cool/sre-demo/k8s-demo/docker.io-grafana-grafana:13.2.1-distroless_amd64
docker pull docker.cnb.cool/sre-demo/k8s-demo/docker.io-library-busybox:1.38.0_amd64
docker pull ghcr.nju.edu.cn/jkroepke/kube-webhook-certgen:1.8.8
docker pull ghcr.nju.edu.cn/kiwigrid/k8s-sidecar:2.11.2
docker pull ghcr.nju.edu.cn/prometheus/node-exporter:v1.12.1-distroless
docker pull ghcr.nju.edu.cn/prometheus-operator/prometheus-operator:v0.93.1
docker pull ghcr.nju.edu.cn/prometheus/prometheus:v3.14.0-distroless
docker pull docker.cnb.cool/sre-demo/k8s-demo/registry.k8s.io-kube-state-metrics-kube-state-metrics:v2.20.0_amd649.3 在线安装 CRD 和 Chart
bash
#提取 CRD 定义
helm show crds prometheus-community/kube-prometheus-stack \
  --version 90.0.0 > kps-online-crds.yaml

#把 CRD 注册到 Kubernetes
kubectl apply --server-side -f kps-online-crds.yaml

#等待  CRD 在 Kubernetes 注册完成
kubectl get crd -o name \
  | grep 'monitoring.coreos.com' \
  | xargs kubectl wait --for=condition=Established --timeout=120s

#模拟检查监控系统 YAML
kubectl apply --dry-run=server -f kps-online-rendered.yaml

#安装 chart
helm upgrade --install kps \
  prometheus-community/kube-prometheus-stack \
  --version 90.0.0 \
  --namespace monitoring \
  --create-namespace \
  -f kps-values.yaml \
  --atomic \
--timeout 15m十、离线 Helm 部署
10.1 离线渲染并提取镜像
bash
cd /etc/kubernetes/addons/kube-prometheus-stack

#检查配置和模板
helm lint ./kube-prometheus-stack-90.0.0.tgz -f kps-values.yaml

#生成最终 Kubernetes YAML
helm template kps \
  ./kube-prometheus-stack-90.0.0.tgz \
  --namespace monitoring \
  -f kps-values.yaml \
  > kps-offline-rendered.yaml


#提取镜像地址
awk '$1 == "image:" {print $2}' kps-offline-rendered.yaml \
  | tr -d "\"'" \
  | sort -u \
  > kps-offline-images.txt

#查看镜像地址
cat kps-offline-images.txt
grep -n 'storageClassName: nfs-dynamic' kps-offline-rendered.yaml
grep -nE 'type: NodePort|nodePort: (30090|30300)' kps-offline-rendered.yaml10.2 离线环境预拉取镜像
bash
docker pull docker.cnb.cool/sre-demo/k8s-demo/docker.io-grafana-grafana:13.2.1-distroless_amd64
docker pull docker.cnb.cool/sre-demo/k8s-demo/docker.io-library-busybox:1.38.0_amd64
docker pull ghcr.nju.edu.cn/jkroepke/kube-webhook-certgen:1.8.8
docker pull ghcr.nju.edu.cn/kiwigrid/k8s-sidecar:2.11.2
docker pull ghcr.nju.edu.cn/prometheus/node-exporter:v1.12.1-distroless
docker pull ghcr.nju.edu.cn/prometheus-operator/prometheus-operator:v0.93.1
docker pull ghcr.nju.edu.cn/prometheus/prometheus:v3.14.0-distroless
docker pull docker.cnb.cool/sre-demo/k8s-demo/registry.k8s.io-kube-state-metrics-kube-state-metrics:v2.20.0_amd6410.3 离线安装 CRD 和 Chart
bash
#提取 CRD 定义
helm show crds ./kube-prometheus-stack-90.0.0.tgz \
  > kps-offline-crds.yaml

#把 CRD 注册到 Kubernetes
kubectl apply --server-side -f kps-offline-crds.yaml

#等待  CRD 在 Kubernetes 注册完成
kubectl get crd -o name \
  | grep 'monitoring.coreos.com' \
  | xargs kubectl wait --for=condition=Established --timeout=120s

#模拟检查监控系统 YAML
kubectl apply --dry-run=server -f kps-offline-rendered.yaml

#安装 chart
helm upgrade --install kps \
  ./kube-prometheus-stack-90.0.0.tgz \
  --namespace monitoring \
  --create-namespace \
  -f kps-values.yaml \
  --rollback-on-failure \
--timeout 15m十一、检查安装结果
bash
helm -n monitoring list
helm -n monitoring status kps
kubectl -n monitoring get pods -o wide
kubectl -n monitoring get pvc -o wide
kubectl -n monitoring get service预期:Prometheus、Operator、Grafana、kube-state-metrics 正常运行,node-exporter 在三个节点各运行一个,Prometheus 和 Grafana PVC 为 Bound。
十二、验证监控
12.1 Prometheus
访问任一可达的 Kubernetes 节点,例如:
text
http://172.22.33.100:30090Prometheus 当前没有登录认证,只允许从受信任管理网访问;后续通过 Traefik Middleware 增加认证。
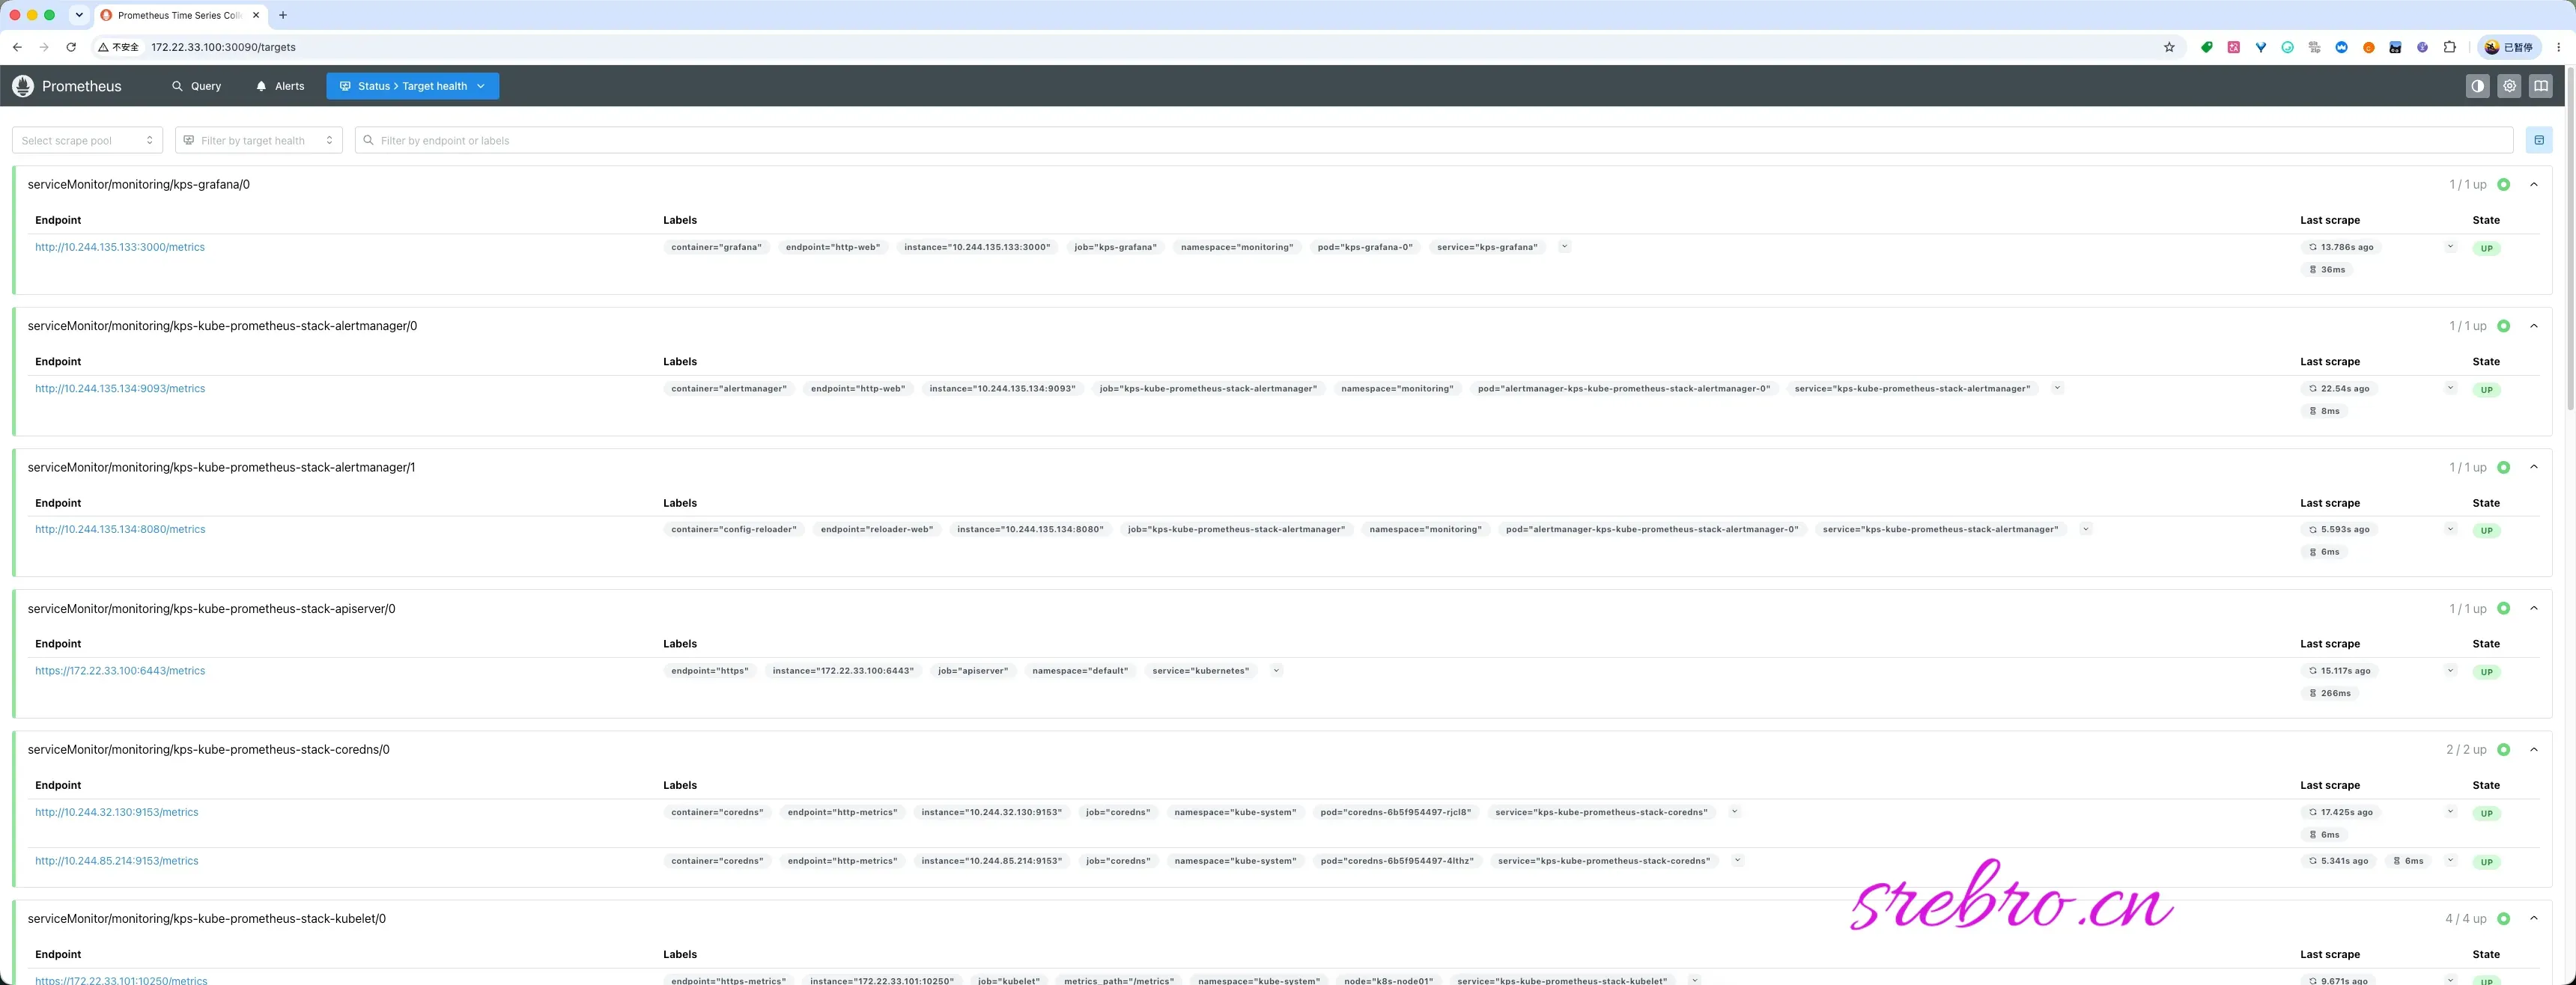
在 Targets 中检查:
- apiserver
- kubelet、kubelet-cadvisor
- coredns
- node-exporter
- kube-state-metrics
- prometheus、prometheus-operator
12.2 node-exporter
验证 node-exporter 监听在宿主机网络9100
从允许访问节点 9100 的机器验证认证:
bash
# 不携带密码,应返回 401
curl -I http://172.22.33.100:9100/metrics

# admin/admin,应返回指标
curl -u admin:admin http://172.22.33.100:9100/metrics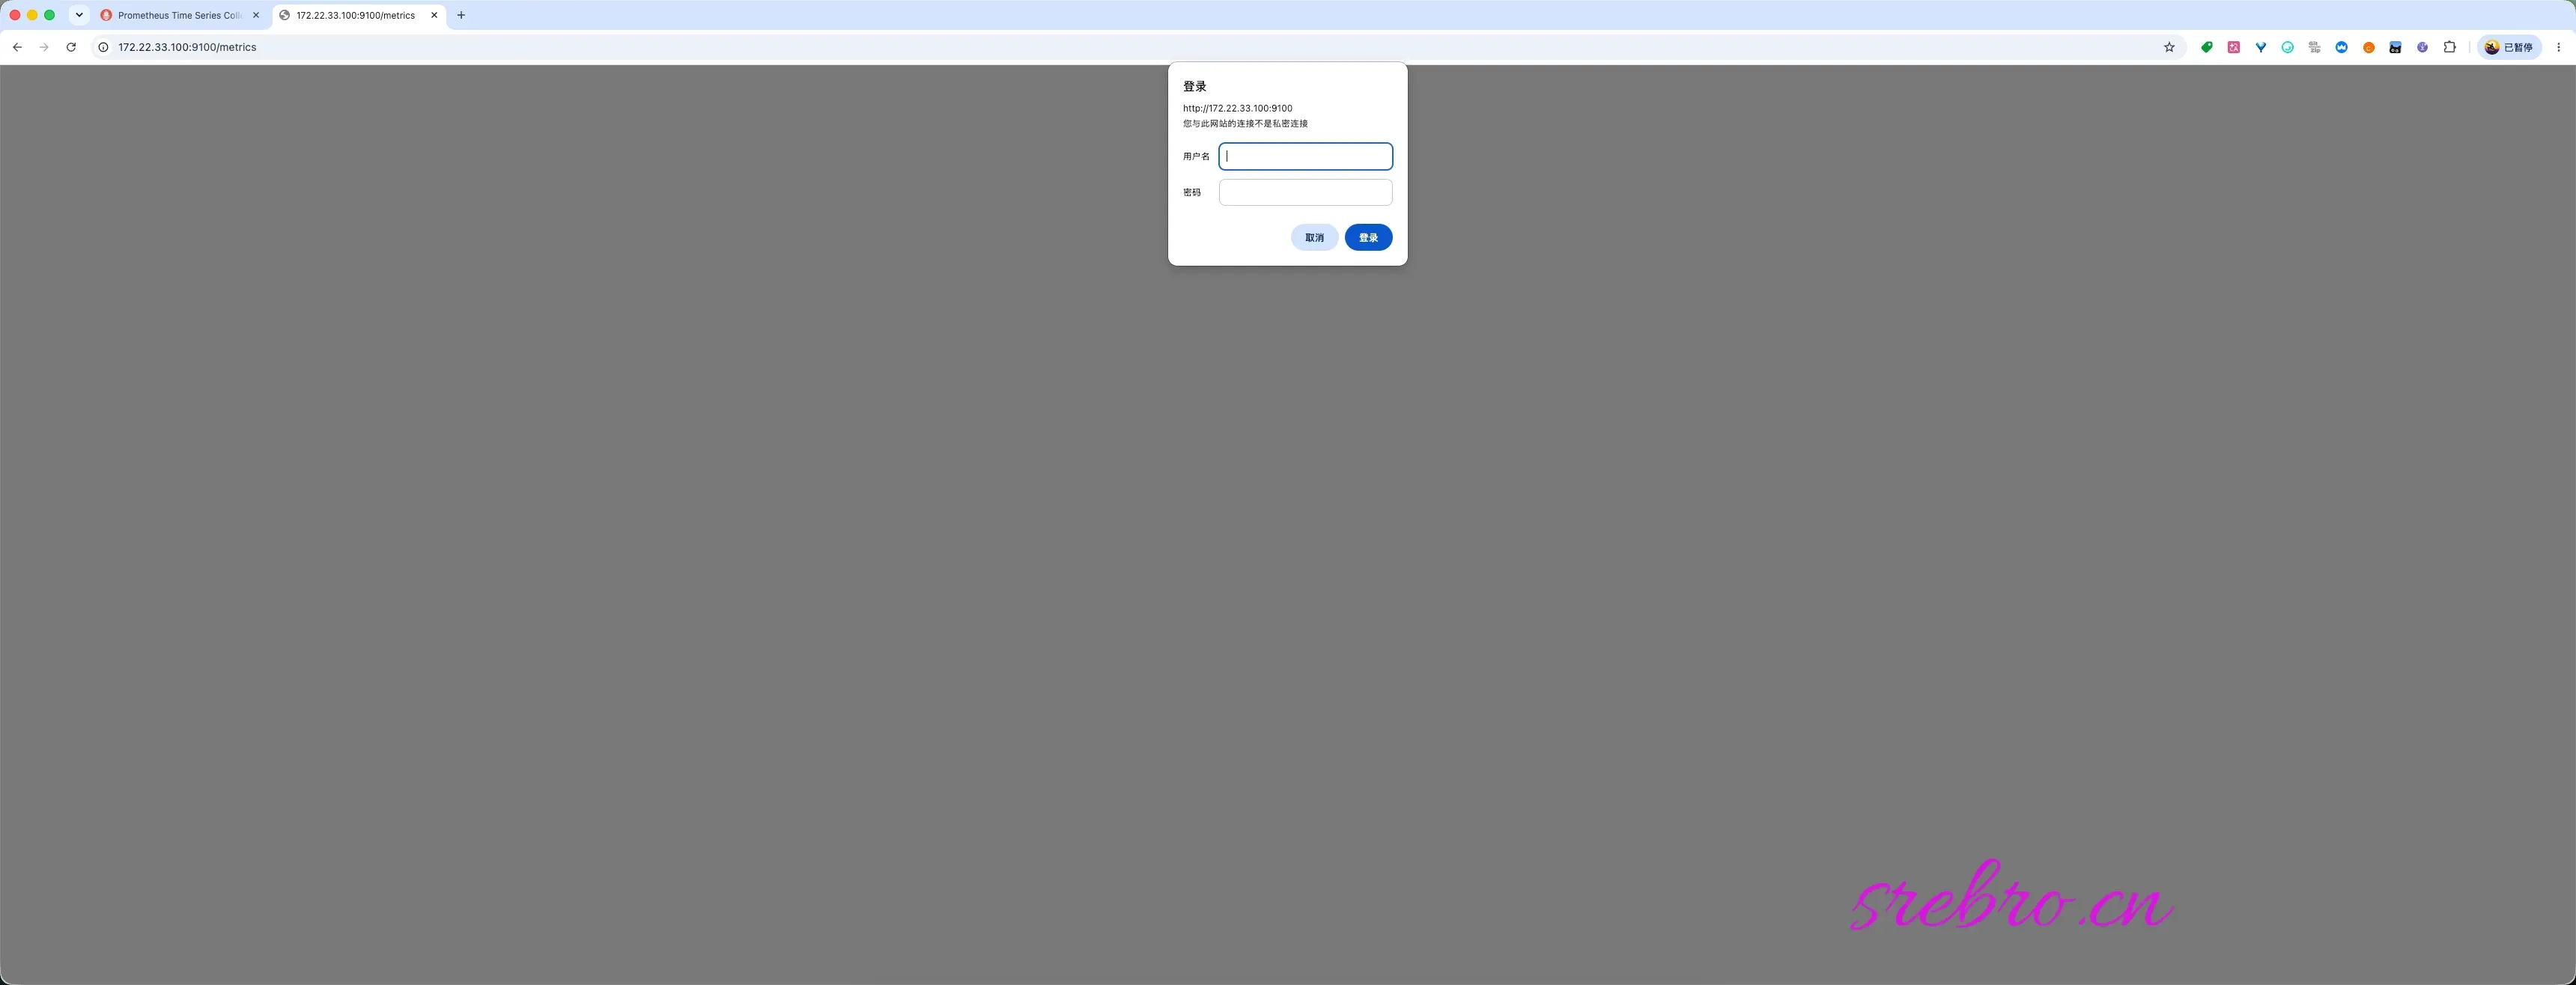
12.3 常用验收 PromQL
K8s 节点状态:
promql
kube_node_status_condition{condition="Ready",status="true"}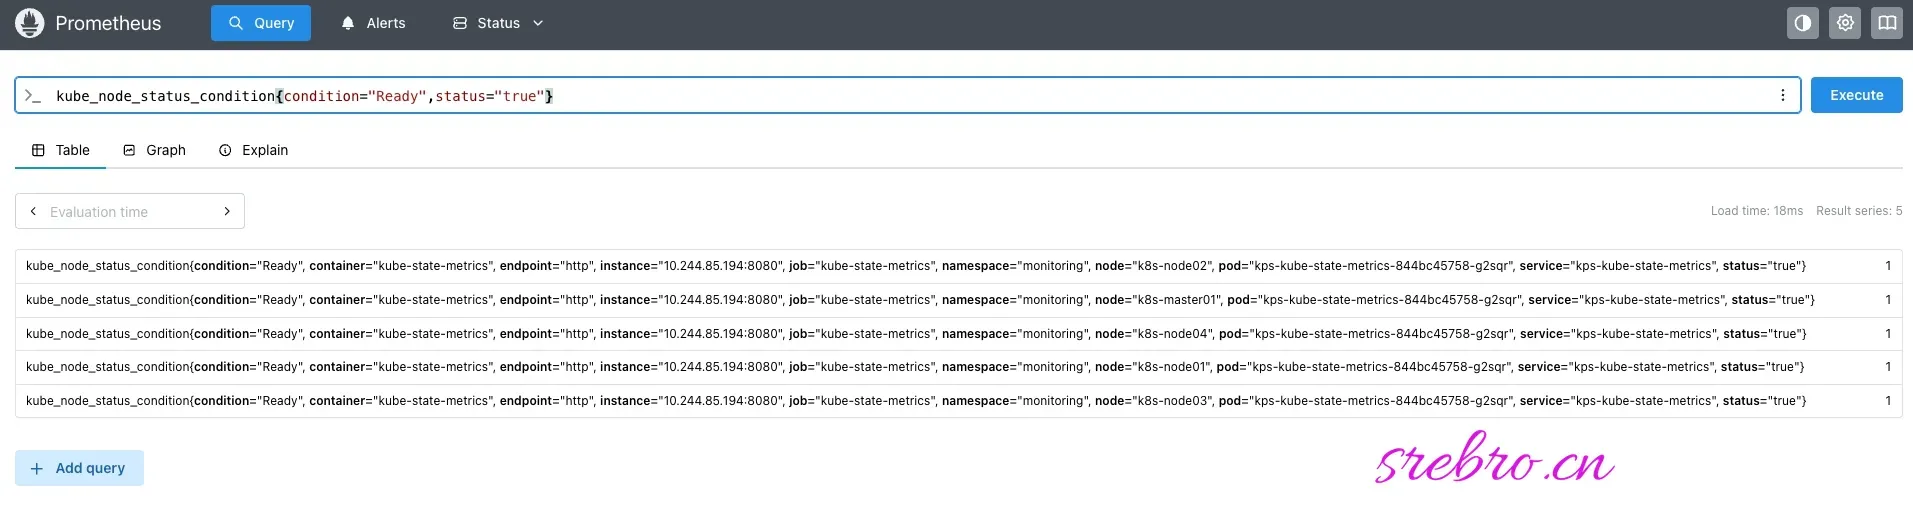
12.4 VictoriaMetrics 远程写入
确认 Prometheus CR 已生成远程写入配置:
bash
kubectl -n monitoring get prometheus -o yaml \
| grep -A 8 -E 'externalLabels:|remoteWrite:'在本地 Prometheus 查询远程写入是否积压或失败:
promql
prometheus_remote_storage_samples_pendingpromql
sum(rate(prometheus_remote_storage_samples_failed_total[5m]))正常情况下,积压和失败速率应接近 0。在 VictoriaMetrics 中按 k8s_type="demo" 查询,应能看到当前集群的数据。
12.5 Grafana
用户名/密码:admin/admin(登录后请修改)
text
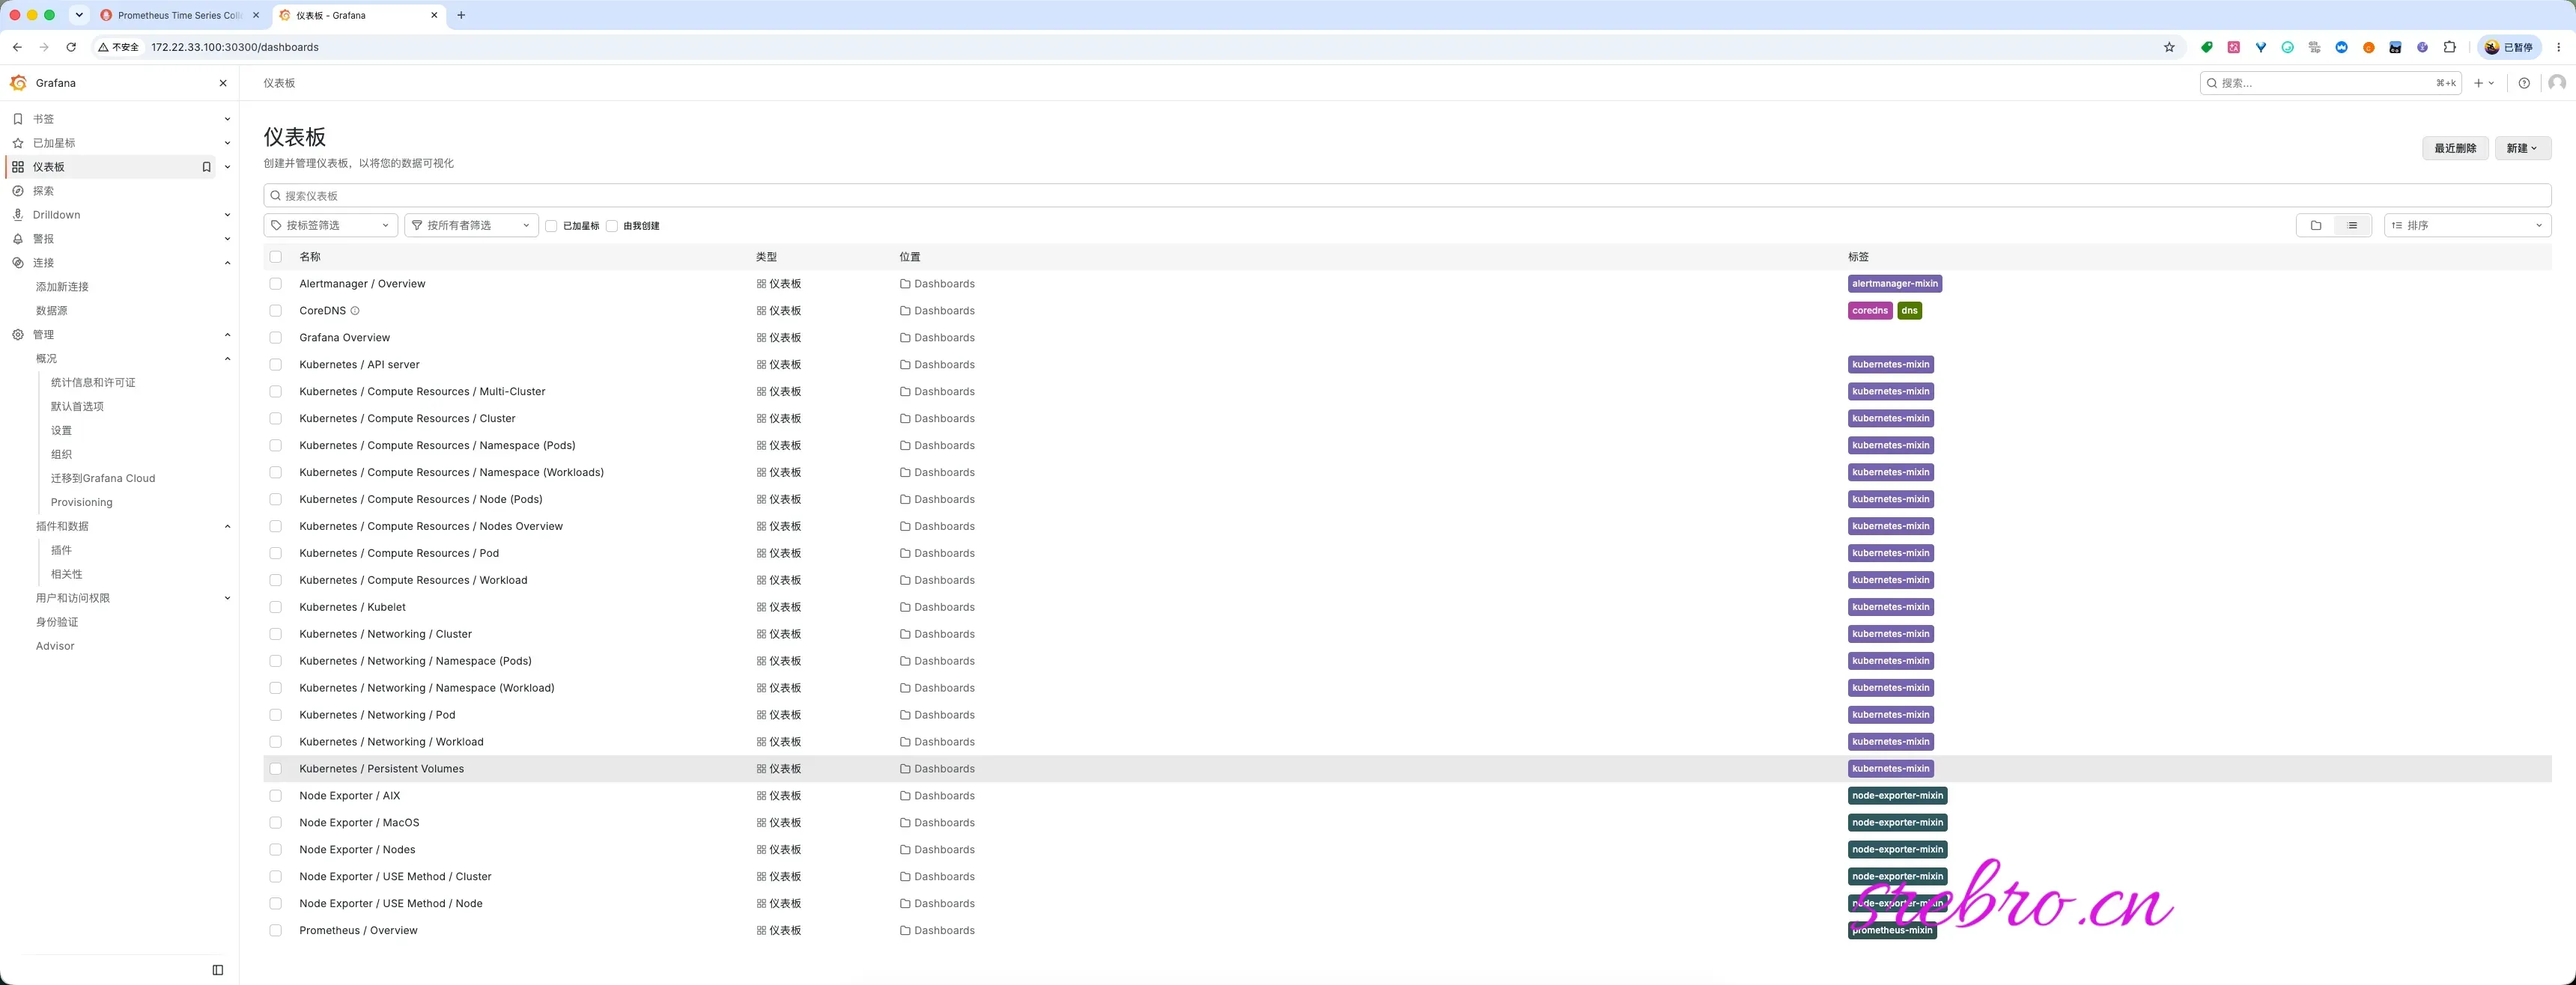
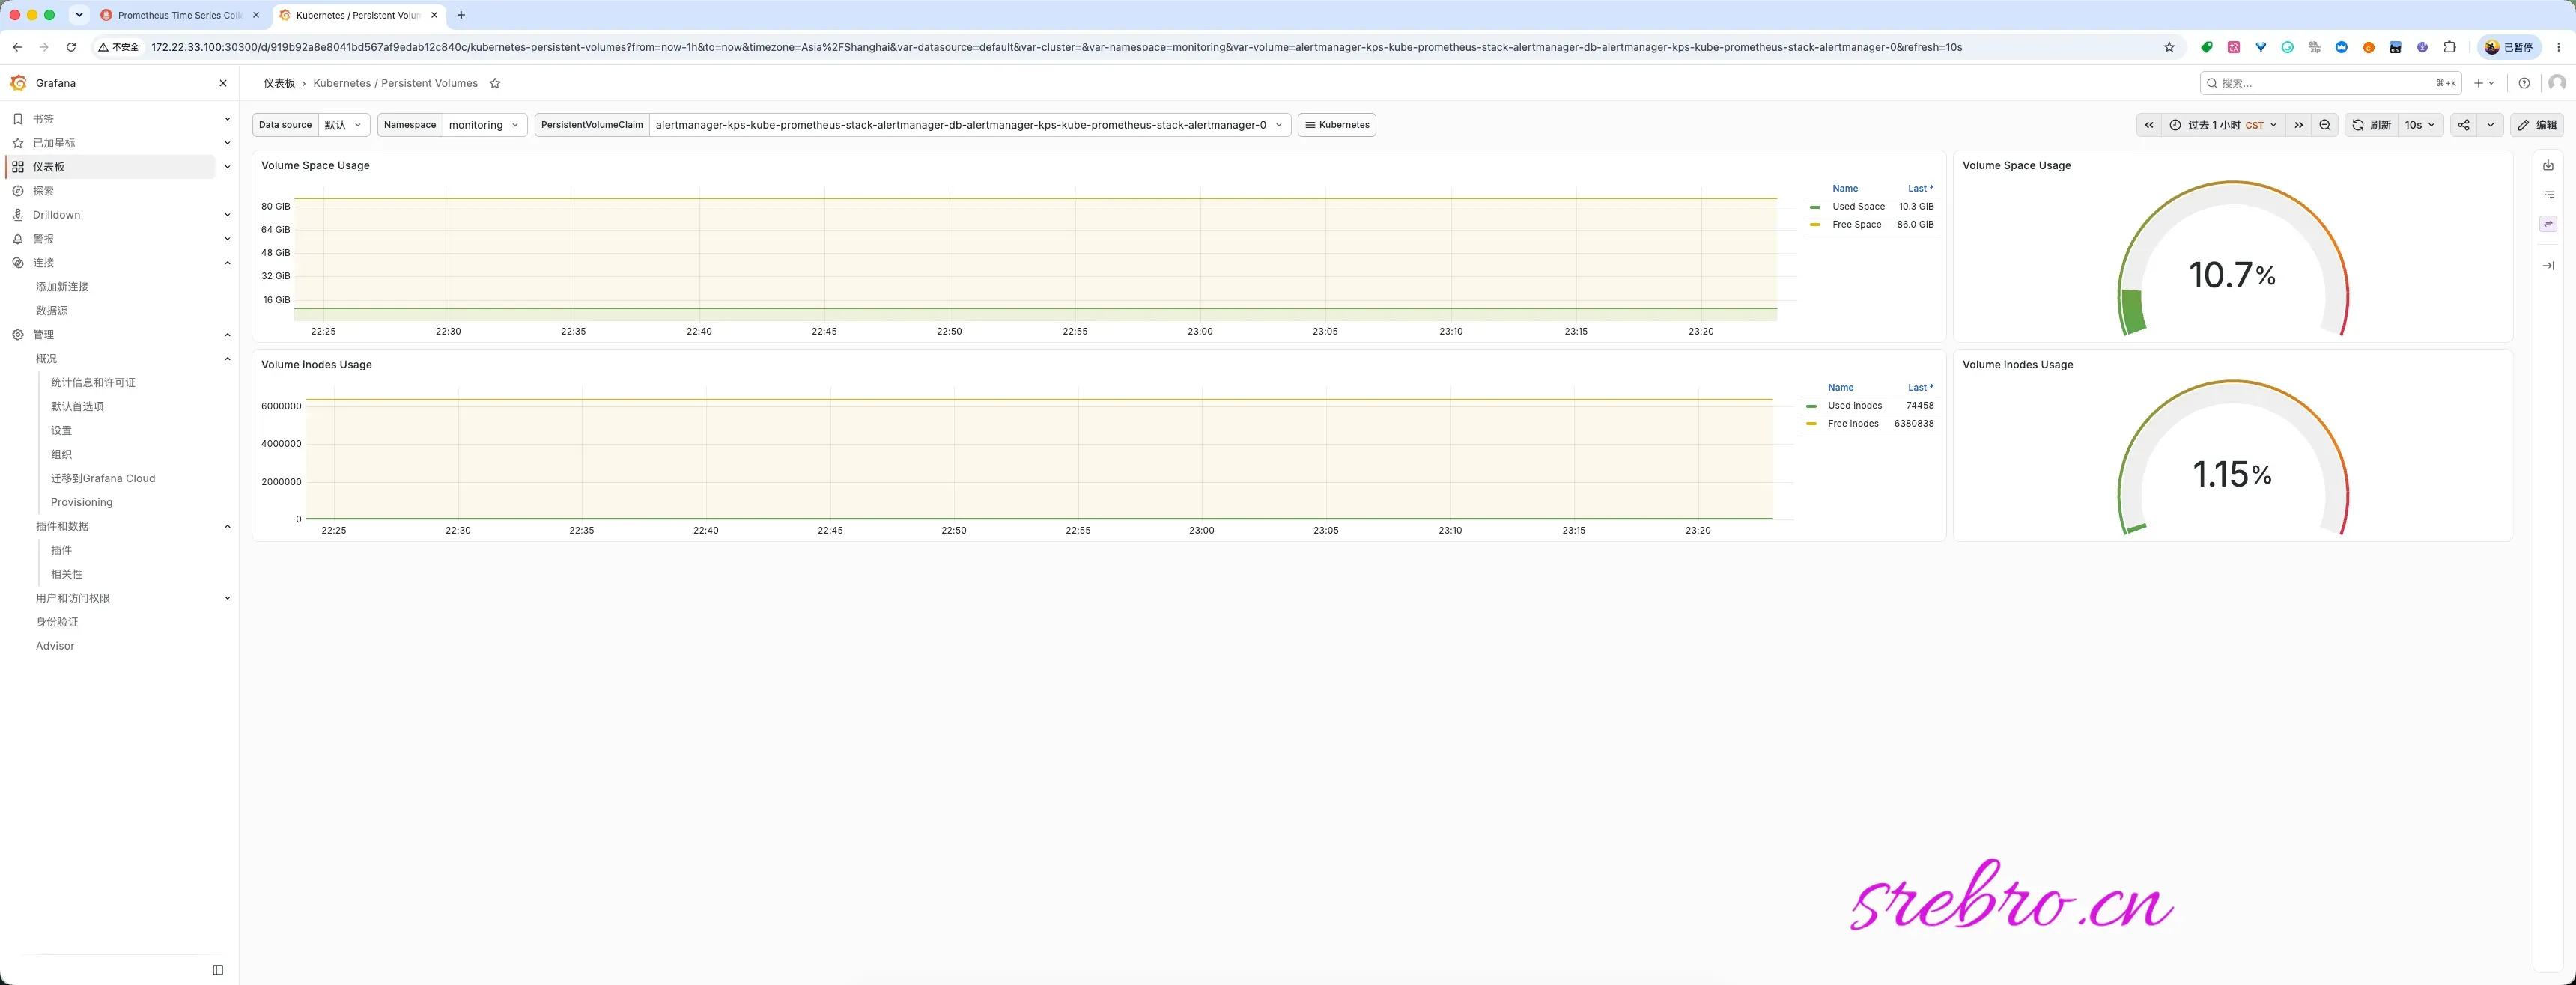
http://172.22.33.100:30300安装完成后,Grafana 中已经预置了许多有用的仪表盘:
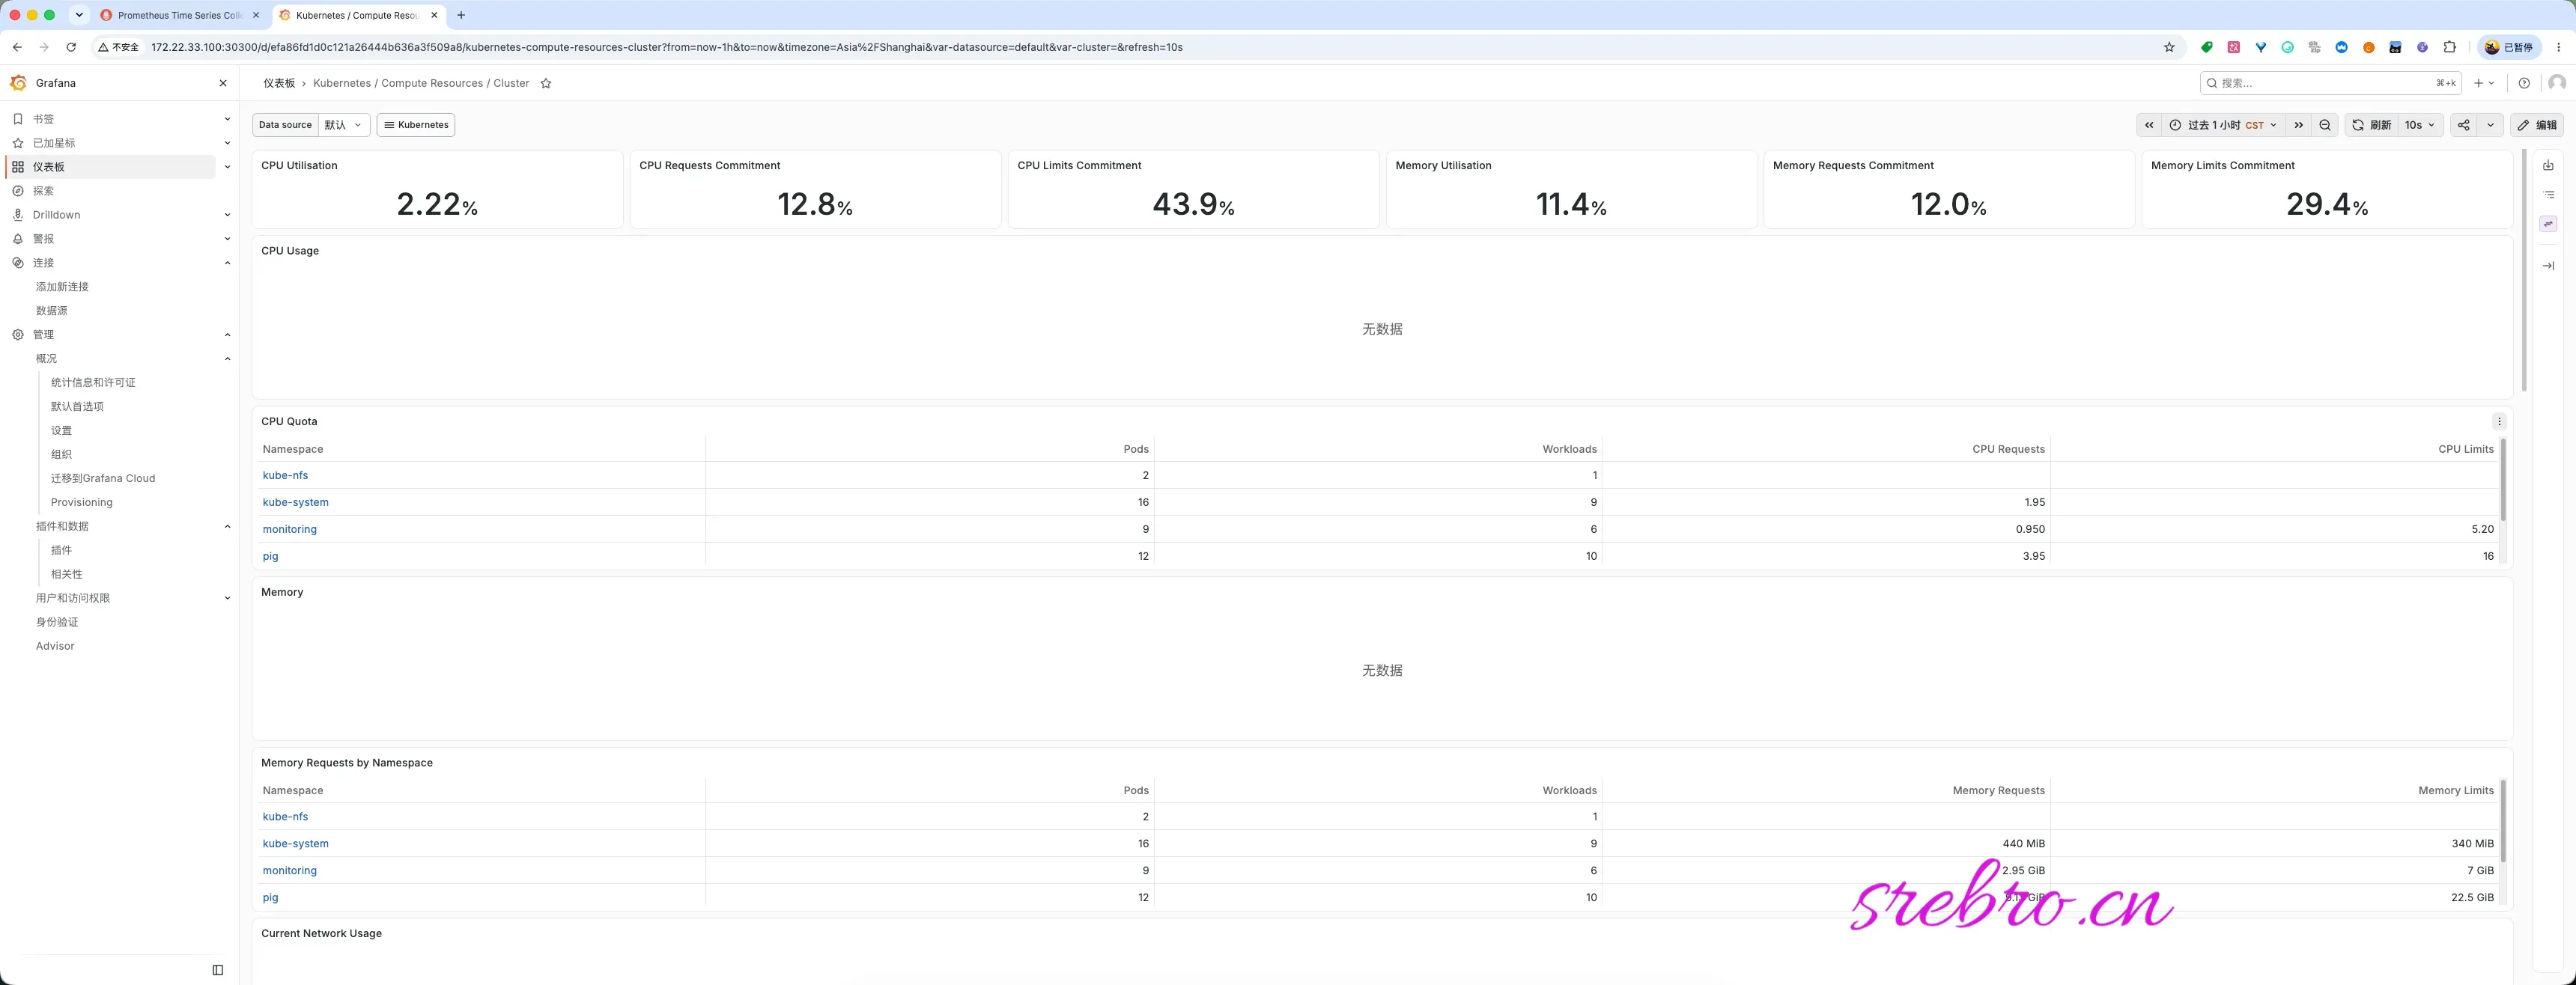
- Kubernetes / Compute Resources / Cluster:集群级别的 CPU、内存、磁盘使用情况。
- Kubernetes / Compute Resources / Namespace (Pods):查看特定命名空间下所有 Pod 的资源使用情况。
- Kubernetes / Compute Resources / Pod:深入查看单个 Pod 的详细资源消耗。
- Node Exporter Dashboard:监控节点的硬件指标,如 CPU 负载、磁盘 IO、网络流量等。
通过这些仪表盘,可以了解:
- 集群健康度:节点是否就绪,资源是否充足。
- 应用性能:Pod 的 CPU/内存使用率是否异常,是否触发了 HPA。
十三、Helm 更新与卸载
13.1 修改 values 后更新
在线 Chart:
bash
helm upgrade kps \
  prometheus-community/kube-prometheus-stack \
  --version 90.0.0 \
  --namespace monitoring \
  -f kps-values.yaml \
  --atomic \
--timeout 15m离线 Chart:
bash
helm upgrade kps \
  ./kube-prometheus-stack-90.0.0.tgz \
  --namespace monitoring \
  -f kps-values.yaml \
  --atomic \
--timeout 15m检查内置 Alertmanager 已关闭:
bash
kubectl -n monitoring get alertmanager
kubectl -n monitoring get pod,service | grep alertmanager || true上述命令应查不到 Alertmanager 实例、Pod 和 Service。之前创建的 Alertmanager PVC 可能因保留策略继续存在,不影响后续使用。
检查远程写入状态:
bash
kubectl -n monitoring get prometheus -o yaml \
| grep -A 8 -E 'externalLabels:|remoteWrite:'13.2 卸载整个监控栈
卸载:
bash
helm uninstall kps --namespace monitoring卸载前先备份 NFS 数据并检查回收策略:
bash
kubectl get storageclass nfs-dynamic -o jsonpath='{.reclaimPolicy}{"\n"}'
kubectl -n monitoring get pvc
kubectl get pv不要随意删除 Prometheus/Grafana PVC、PV、NFS 数据目录或 Prometheus Operator CRD。
十四、Kubernetes 监控告警规则(26 条)
NOTE
本示例不阐述告警平台的部署;使用官方 Alertmanager、夜莺(Nightingale)或 WatchAlert 均可。
规则分为 node、pod、workload、storage、apiserver 五类。告警级别只使用:
critical:服务不可用、节点异常或存储即将耗尽,需要立即处理。warning:资源紧张或运行状态异常,需要尽快检查。
yaml
groups:
  - name: kubernetes-alerts
    rules:
      # 节点健康
      - alert: KubernetesNodeOutOfPodCapacity
        expr: >-
          sum by (node, k8s_type) (
            (kube_pod_status_phase{phase="Running"} == 1)
            + on (uid, instance) group_left(node) (0 * kube_pod_info)
          )
          / sum by (node, k8s_type) (kube_node_status_allocatable{resource="pods"})
          * 100 > 90
        for: 2m
        labels:
          severity: warning
          alert_cat: node
        annotations:
          summary: "K8s 节点 Pod 容量超过 90%"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} Pod 使用率为 {{ $value }}%。"

      - alert: KubernetesNodeMemoryPressure
        expr: kube_node_status_condition{condition="MemoryPressure",status="true"} == 1
        for: 2m
        labels:
          severity: critical
          alert_cat: node
        annotations:
          summary: "K8s 节点内存压力"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} 出现 MemoryPressure。"

      - alert: KubernetesNodeNotReady
        expr: kube_node_status_condition{condition="Ready",status="true"} == 0
        for: 10m
        labels:
          severity: critical
          alert_cat: node
        annotations:
          summary: "K8s 节点 NotReady"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} 已持续 10 分钟未就绪。"

      - alert: KubernetesNodeRebooted
        expr: time() - node_boot_time_seconds{job="node-exporter"} < 300
        for: 0m
        labels:
          severity: critical
          alert_cat: node
        annotations:
          summary: "K8s 节点发生重启"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.instance }} 在 5 分钟内发生过重启。"

      - alert: KubernetesNodeDiskPressure
        expr: kube_node_status_condition{condition="DiskPressure",status="true"} == 1
        for: 2m
        labels:
          severity: critical
          alert_cat: node
        annotations:
          summary: "K8s 节点磁盘压力"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} 出现 DiskPressure。"

      - alert: KubernetesNodeNetworkUnavailable
        expr: kube_node_status_condition{condition="NetworkUnavailable",status="true"} == 1
        for: 2m
        labels:
          severity: critical
          alert_cat: node
        annotations:
          summary: "K8s 节点网络不可用"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} 网络不可用。"

      - alert: KubernetesNodeSchedulingDisabled
        expr: kube_node_spec_unschedulable == 1
        for: 30m
        labels:
          severity: warning
          alert_cat: node
        annotations:
          summary: "K8s 节点长时间禁止调度"
          description: "集群 {{ $labels.k8s_type }} 节点 {{ $labels.node }} 已禁止调度 30 分钟。"

      # Pod 与容器
      - alert: KubernetesDaemonSetMisscheduled
        expr: kube_daemonset_status_number_misscheduled > 0
        for: 1m
        labels:
          severity: warning
          alert_cat: pod
        annotations:
          summary: "K8s DaemonSet Pod 调度错误"
          description: "集群 {{ $labels.k8s_type }} DaemonSet {{ $labels.namespace }}/{{ $labels.daemonset }} 存在错误调度的 Pod。"

      - alert: KubernetesPodCPUHigh
        expr: >-
          sum by (namespace, pod, k8s_type) (
            rate(container_cpu_usage_seconds_total{namespace!="",container=""}[5m])
          )
          / on (namespace, pod, k8s_type)
          (sum by (namespace, pod, k8s_type) (
            kube_pod_container_resource_limits{resource="cpu",unit="core"}
          ) > 0)
          * 100 > 80
        for: 5m
        labels:
          severity: warning
          alert_cat: pod
        annotations:
          summary: "K8s Pod CPU 使用率超过 80%"
          description: "集群 {{ $labels.k8s_type }} Pod {{ $labels.namespace }}/{{ $labels.pod }} CPU 使用率为 {{ $value }}%。"

      - alert: KubernetesPodMemoryHigh
        expr: >-
          sum by (namespace, pod, k8s_type) (
            container_memory_working_set_bytes{namespace!="",container=""}
          )
          / on (namespace, pod, k8s_type)
          (sum by (namespace, pod, k8s_type) (
            kube_pod_container_resource_limits{resource="memory",unit="byte"}
          ) > 0)
          * 100 > 80
        for: 5m
        labels:
          severity: warning
          alert_cat: pod
        annotations:
          summary: "K8s Pod 内存使用率超过 80%"
          description: "集群 {{ $labels.k8s_type }} Pod {{ $labels.namespace }}/{{ $labels.pod }} 内存使用率为 {{ $value }}%。"

      - alert: KubernetesPodNotHealthy
        expr: sum by (namespace, pod, k8s_type, phase) (kube_pod_status_phase{phase=~"Pending|Unknown|Failed"}) > 0
        for: 15m
        labels:
          severity: critical
          alert_cat: pod
        annotations:
          summary: "K8s Pod 长时间状态异常"
          description: "集群 {{ $labels.k8s_type }} Pod {{ $labels.namespace }}/{{ $labels.pod }} 处于 {{ $labels.phase }} 状态超过 15 分钟。"

      - alert: KubernetesContainerOOMKilled
        expr: >-
          (kube_pod_container_status_restarts_total
          - kube_pod_container_status_restarts_total offset 10m >= 1)
          and ignoring (reason)
          min_over_time(kube_pod_container_status_last_terminated_reason{reason="OOMKilled"}[10m]) == 1
        for: 0m
        labels:
          severity: warning
          alert_cat: pod
        annotations:
          summary: "K8s 容器发生 OOMKilled"
          description: "集群 {{ $labels.k8s_type }} 容器 {{ $labels.namespace }}/{{ $labels.pod }}/{{ $labels.container }} 在 10 分钟内发生 OOMKilled。"

      # 工作负载
      - alert: KubernetesDaemonSetRolloutStuck
        expr: kube_daemonset_status_desired_number_scheduled != kube_daemonset_status_number_ready
        for: 10m
        labels:
          severity: warning
          alert_cat: workload
        annotations:
          summary: "K8s DaemonSet 发布未完成"
          description: "集群 {{ $labels.k8s_type }} DaemonSet {{ $labels.namespace }}/{{ $labels.daemonset }} Ready 数与期望数不一致。"

      - alert: KubernetesDeploymentReplicasMismatch
        expr: kube_deployment_spec_replicas != kube_deployment_status_replicas_available
        for: 10m
        labels:
          severity: warning
          alert_cat: workload
        annotations:
          summary: "K8s Deployment 副本数不一致"
          description: "集群 {{ $labels.k8s_type }} Deployment {{ $labels.namespace }}/{{ $labels.deployment }} 可用副本数未达到期望值。"

      - alert: KubernetesDeploymentRolloutStuck
        expr: kube_deployment_status_condition{condition="Progressing",status="false"} == 1
        for: 10m
        labels:
          severity: warning
          alert_cat: workload
        annotations:
          summary: "K8s Deployment 发布卡住"
          description: "集群 {{ $labels.k8s_type }} Deployment {{ $labels.namespace }}/{{ $labels.deployment }} 长时间没有发布进展。"

      - alert: KubernetesReplicaSetReplicasMismatch
        expr: kube_replicaset_spec_replicas != kube_replicaset_status_ready_replicas
        for: 10m
        labels:
          severity: warning
          alert_cat: workload
        annotations:
          summary: "K8s ReplicaSet 副本数不一致"
          description: "集群 {{ $labels.k8s_type }} ReplicaSet {{ $labels.namespace }}/{{ $labels.replicaset }} Ready 数未达到期望值。"

      - alert: KubernetesStatefulSetReplicasMismatch
        expr: kube_statefulset_status_replicas_ready != kube_statefulset_status_replicas
        for: 10m
        labels:
          severity: warning
          alert_cat: workload
        annotations:
          summary: "K8s StatefulSet 副本数不一致"
          description: "集群 {{ $labels.k8s_type }} StatefulSet {{ $labels.namespace }}/{{ $labels.statefulset }} Ready 数未达到期望值。"

      - alert: KubernetesStatefulSetDown
        expr: kube_statefulset_replicas > 0 and kube_statefulset_status_replicas_ready == 0
        for: 3m
        labels:
          severity: critical
          alert_cat: workload
        annotations:
          summary: "K8s StatefulSet 整体不可用"
          description: "集群 {{ $labels.k8s_type }} StatefulSet {{ $labels.namespace }}/{{ $labels.statefulset }} 没有 Ready 副本。"

      # 存储
      - alert: KubernetesPersistentVolumeClaimPending
        expr: kube_persistentvolumeclaim_status_phase{phase="Pending"} == 1
        for: 2m
        labels:
          severity: warning
          alert_cat: storage
        annotations:
          summary: "K8s PVC 长时间 Pending"
          description: "集群 {{ $labels.k8s_type }} PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} 处于 Pending 状态。"

      - alert: KubernetesVolumeInodesFullInFourDays
        expr: predict_linear(kubelet_volume_stats_inodes_free[6h:5m], 4 * 24 * 3600) < 0
        for: 0m
        labels:
          severity: critical
          alert_cat: storage
        annotations:
          summary: "K8s 卷 inode 预计 4 天内耗尽"
          description: "集群 {{ $labels.k8s_type }} PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} 的 inode 预计 4 天内耗尽。"

      - alert: KubernetesVolumeOutOfInodes
        expr: kubelet_volume_stats_inodes_free / kubelet_volume_stats_inodes < 0.03 and kubelet_volume_stats_inodes > 0
        for: 2m
        labels:
          severity: warning
          alert_cat: storage
        annotations:
          summary: "K8s 卷可用 inode 低于 3%"
          description: "集群 {{ $labels.k8s_type }} PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} 可用 inode 低于 3%。"

      - alert: KubernetesVolumeOutOfDiskSpace
        expr: kubelet_volume_stats_available_bytes / kubelet_volume_stats_capacity_bytes * 100 < 10 and kubelet_volume_stats_capacity_bytes > 0
        for: 2m
        labels:
          severity: critical
          alert_cat: storage
        annotations:
          summary: "K8s 卷可用空间低于 10%"
          description: "集群 {{ $labels.k8s_type }} PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} 可用空间低于 10%。"

      - alert: KubernetesVolumeFullInFourDays
        expr: predict_linear(kubelet_volume_stats_available_bytes[6h:5m], 4 * 24 * 3600) < 0
        for: 0m
        labels:
          severity: warning
          alert_cat: storage
        annotations:
          summary: "K8s 卷预计 4 天内写满"
          description: "集群 {{ $labels.k8s_type }} PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} 预计 4 天内写满。"

      - alert: KubernetesPersistentVolumeError
        expr: kube_persistentvolume_status_phase{phase=~"Failed|Pending"} > 0
        for: 2m
        labels:
          severity: critical
          alert_cat: storage
        annotations:
          summary: "K8s PV 状态异常"
          description: "集群 {{ $labels.k8s_type }} PV {{ $labels.persistentvolume }} 处于 {{ $labels.phase }} 状态。"

      # API Server 与监控链路
      - alert: KubernetesAPIServerLatencyHigh
        expr: >-
          histogram_quantile(
            0.99,
            sum by (k8s_type, le) (
              rate(apiserver_request_duration_seconds_bucket{verb!~"CONNECT|WATCHLIST|WATCH|PROXY"}[10m])
            )
          ) > 1
        for: 2m
        labels:
          severity: warning
          alert_cat: apiserver
        annotations:
          summary: "K8s API Server P99 延迟超过 1 秒"
          description: "集群 {{ $labels.k8s_type }} API Server P99 延迟为 {{ $value }} 秒。"

      - alert: KubernetesKubeStateMetricsUnavailable
        expr: >-
          (min by (k8s_type, job) (
            up{job="kube-state-metrics",k8s_type=~"demo|sre"}
          ) == 0)
          or (absent_over_time(
            up{job="kube-state-metrics",k8s_type="demo"}[10m]
          ) == 1)
          or (absent_over_time(
            up{job="kube-state-metrics",k8s_type="sre"}[10m]
          ) == 1)
        for: 2m
        labels:
          severity: critical
          alert_cat: apiserver
        annotations:
          summary: "K8s kube-state-metrics 采集失败"
description: "集群 {{ $labels.k8s_type }} 的 kube-state-metrics 抓取失败或连续 10 分钟没有上报。"14.1 维护说明
- 新增集群时,同步修改
k8s_type=~"demo|sre",并增加对应的absent_over_time。 - CPU 和内存规则只监控已配置
limits的 Pod。 - 阈值需根据实际业务调整。
十五、参考资料
- https://github.com/prometheus-community/helm-charts/tree/main/charts/kube-prometheus-stack
- https://prometheus-operator.dev/
- https://github.com/kubernetes/kube-state-metrics
- https://github.com/prometheus/node_exporter#tls-endpoint
- https://prometheus.io/docs/prometheus/latest/storage/
- https://kubernetes.io/docs/concepts/cluster-administration/system-metrics/
- https://helm.sh/docs/intro/install/
- https://github.com/helm/helm/releases
- https://github.com/opsre/WatchAlert
- https://cairry.github.io/docs/install/k8s.html
- Kubernetes 1.36 使用 Helm 部署 Traefik — 安装 Helm
- https://blog.csdn.net/L162476/article/details/156946910
- https://samber.github.io/awesome-prometheus-alerts/rules/orchestrators/kubernetes/